给 Agent 一本操作手册:一文读懂 Skills 与 Matt Pocock 的工程技能包

如果你已经在用 AI 编程助手写代码,多半经历过这样的落差:让模型「写个测试」,它给你一份测试,但没跑过一次;让它「修个 bug」,它改了三行、顺手重构了半个文件。模型很聪明,但它不知道你的工程纪律。Skills 就是补上这一块的机制 —— 给 Agent 一本可以按需翻开的操作手册。本文分两部分:先讲清 Skills 机制的原理(为什么它有效、Agent 是怎么「自主选择」的),再拆解目前社区里最成体系的一套 —— Matt Pocock 的「Skills For Real Engineers」(25 个,公开仓库 mattpocock/skills)。

一、Skill 到底是什么

一个 skill 就是一个文件夹,核心是一份 SKILL.md:一段 description + 一套操作指令,,可选地带上可执行脚本和参考文档。它不是插件、不是扩展 API,本质就是结构化的 prompt——但被文件系统组织起来、按需加载。

它要解决的问题很具体:模型的上下文窗口有限,不可能把所有工程纪律常驻在每次对话里。Skills 的做法是:

  • 平时只注入元数据:会话开始时,每个 skill 的名称和一行 description 进入系统提示(几十行就装下几十个 skill);
  • 用时才加载正文:命中时才把完整指令读进上下文,用完即弃。

这本质上是给 Agent 装了一个「按需检索的程序性知识库」——声明式知识(是什么)模型自己有,程序性知识(你们团队怎么做)靠 skill 补。

二、Agent 怎么「自主选择」一个 skill

机制分四步,理解了它,你就知道该把精力花在哪个环节:

  1. 清单注入:会话开始,所有 skill 的名称 + description 作为元数据注入系统提示。完整正文并不加载。
  2. 语义匹配:处理请求时,Agent 把任务描述和这些 description 做语义匹配。匹配命中,就调用工具加载对应的 SKILL.md,再按里面的流程干活。
  3. 两种触发方式:
    • 显式触发:用户输入 /skill-name,无条件加载——适合「编排型」流程(比如”开始评审”);
    • 自主触发:Agent 根据 description 自己判断——适合「纪律型」技能(比如 TDD 循环、调试流程)。
  4. 优先级:同名时用户级目录覆盖插件级目录——这既是定制入口,也是坑(后面讲)。

由此得出一个关键推论:自主触发的质量,完全取决于 description 的写法。写得越具体、越包含真实场景下的触发短语(”diagnose this crash”、”red-green-refactor”),命中率越高。description 不是简介,是这个 skill 的全部入口。反过来,这也解释了为什么 skill 要「小而聚焦」——一个试图覆盖所有场景的 description,在语义匹配时反而哪个场景都命中不好。

三、写好一个 skill 的几条经验

无论自己写还是改别人的,这几条反复被验证:

  • description 写触发场景,不写功能清单。「用于调试难以复现的 bug,当用户报告 flaky test 或间歇性崩溃时使用」远好于「一个强大的调试工具」。
  • 正文写给未来的 Agent,不是写给人看。指令要用祈使句、按执行顺序组织、把「检查点」写明白(”先跑测试确认变红,再动手修”),因为读者是一个没有你当前对话记忆的新会话。
  • 一件事一个 skill。小 skill 可以组合成大流程(后面 matt 的工作流就是这样串的),大而全的 skill 无法复用也无法调试。
  • 可执行的部分就写成脚本。与其用自然语言描述”检查 XX 格式”,不如附带一个校验脚本——Agent 执行脚本比理解散文可靠得多。
  • 小心重复安装。同一个 skill 从插件和从文件管理器各装一份,会产生两个同名副本——裸名称会解析到你本地那份可编辑副本,插件更新就悄悄失效了。装一套就好。

四、Matt Pocock 的「Skills For Real Engineers」

Matt Pocock 是 TypeScript 社区的知名教育者(Total TypeScript 作者),他开源的这套 skill 集合是目前社区里体系感最强的一套。README 里开宗明义的设计哲学值得全文引用:

开发真实的应用很难。GSD、BMAD、Spec-Kit 这类方法试图通过接管整个流程来帮你——但代价是夺走你的控制权,让流程中的 bug 难以排查。这些 skills 设计得小、易改、可组合。基于几十年的工程经验。拿去魔改,变成你自己的。

4.1 四个失败模式,四组解药

这套技能的骨架,是 Matt 总结的四个 agent 高频失败模式。每个模式对应一组 skill:

失败模式 对应 skills 思路
#1 Agent 做的不是我想要的(需求错位) grill-me / grill-with-docs 拷问式访谈:让 Agent 反过来连环追问你,把模糊需求磨清楚——这是他最受欢迎的 skill
#2 Agent 太啰嗦 / 说不到点上(缺乏共享语言) domain-modeling、writing-for-agents 给项目建立术语表和决策记录,人和 Agent 说同一种话
#3 代码跑不起来(反馈回路缺失) tdd、diagnosing-bugs 红-绿-重构的垂直切片;调试的分阶段纪律循环
#4 造出一坨泥球(架构熵增) codebase-design、improve-codebase-architecture Ousterhout「深模块」设计词汇;定期扫描架构债

4.2 编排型与纪律型:两层结构

这套技能内部分了两层,正好对应前文说的两种触发方式:

编排型(显式 / 触发)——你主动发起的流程入口:

  • ask-matt:路由器。不知道该用哪个 skill 时问它;
  • grill-with-docs:拷问式访谈 + 顺手沉淀 CONTEXT.md(项目词汇表)和 ADR(架构决策记录)——一次对话同时解决 #1 和 #2;
  • to-spec:把当前对话直接合成一份 spec 发布到 issue tracker;
  • to-tickets:把计划拆成一串「曳光弹」ticket,并声明相互的阻塞关系;
  • implement:按 spec/ticket 实现,过程中驱动 tdd,收尾自动跑 code-review;
  • wayfinder:超过一个会话能装下的大工程——拆成「决策 ticket 地图」,逐个解决;
  • triage:按分诊状态机处理 issue 和外部 PR,产出 Agent 可直接执行的 brief;
  • setup-...:每个仓库跑一次的初始化(配置 issue tracker、标签、文档位置)。

纪律型(Agent 自主触发)——内嵌的工程纪律,在编排流程里被调用,也可以单独生效:

  • tdd:一次一个垂直切片的红-绿-重构;
  • diagnosing-bugs:复现变红 → 最小化 → 假设 → 插桩 → 修复 → 回归测试的完整循环;
  • code-review:双轴评审——既查是否符合仓库编码规范,也查是否忠实实现了 spec;
  • codebase-design:给 Agent 装上「深模块 / 浅模块」的架构词汇;
  • 还有原型验证、调研(带引用)、合并冲突解决(按双方意图逐块处理,永不粗暴 abort)、生成交互式向导带人配密钥等。

4.3 把工作流串起来

单个 skill 是零件,串起来才是生产力。Matt 给出的典型闭环:

1
2
3
4
5
6
7
8
9
10
11
setup(每仓库一次)
↓
grill-with-docs ←—— 拷问式对齐需求,沉淀术语表
↓
to-spec ←—— 对话合成规格,发布到 tracker
↓
to-tickets ←—— 拆成有阻塞关系的 ticket
↓
implement ←—— 内部驱动 tdd,收尾跑 code-review
↓
triage ←—— 回收新 issue,进入下一轮

小改动不用走全流程——implement 单独就能干;大工程把 wayfinder 顶在前面;平时调试和架构维护随时独立触发。框架接管流程,skills 只在你需要纪律的地方提供纪律——这是它和 BMAD 类重框架的分野。

五、几点实践建议

结合自己一段时间的使用,给想上手的几条:

  1. 从两个 skill 开始:tdd(纪律型,立刻有体感)和 grill-me(编排型,治「需求错位」的立竿见影)。不要一上来装 25 个。
  2. description 优先:用一段时间后,把没被自主触发过的 skill 翻出来看 description——八成是触发词写得太文艺。
  3. 让 skill 沉淀你的规范:把团队的 code review checklist、发布流程写成 skill,比塞在聊天记录里强一个数量级——它是可版本管理、可迭代、可分享的。
  4. 警惕双份安装(前文第三节的坑):插件版管更新,本地版管魔改,二选一。
  5. 中文场景完全可用:指令是英文还是中文不影响效果——语义匹配跨语言工作良好;写自己的 skill 时直接用中文 description 也行。

六、结语

Skills 机制的本质,是把「怎么干活」从对话的偶然输入,变成可版本管理、可复用、可组合的工程资产。Matt Pocock 这套技能包的价值不在于 25 个具体 skill,而在于它示范了一种组织方式:用小组件对治大框架,用显式编排承载流程,用自主纪律保证质量,用文档沉淀对抗遗忘。

AI 编程工具的竞争正在从「谁的模型更强」转向「谁的工程语境更完整」。Skills 是这条路上目前最轻、也最开放的一块拼图——而它只是一份 Markdown。
参考

从 WebGL 到 WebGPU:给小朋友写一个 three.js 太阳系

本文是给家里小朋友做「太阳系漫游」网页(直达)过程中的技术调研与实践记录:先简单梳理浏览器 3D 技术的发展脉络,然后看两份有代表性的资料——three.js 官方的 llms.txt 和一个用 WebGPU 手写引擎的钓鱼游戏 Tidewater,最后拆解我们自己的太阳系架构与踩坑实录。全文无框架、零构建依赖,代码都在 GitHub。

一、浏览器 3D 的十五年

把时间线拉长看,网页 3D 大致经历了四个阶段:

  • 插件时代(2006–2011):3D 内容靠 Flash(Away3D)、Unity Web Player、Java Applet 这类插件承载,浏览器本身对 3D 一无所知。
  • WebGL 时代(2011–2022):2011 年 3 月 Khronos 发布 WebGL 1.0(基于 OpenGL ES 2.0),浏览器第一次原生拥有 GPU 渲染能力;同年 mrdoob(Ricardo Cabello)开源了 three.js。2017 年 WebGL 2.0 与 glTF 2.0 格式先后落地,前者带来实例化渲染等能力,后者统一了 3D 模型的「JPEG」标准。
  • WebGPU 时代(2023– ):2023 年 4 月 Chrome 113 默认启用 WebGPU——对标 Vulkan/Metal/DirectX 12 的现代图形 API,支持计算着色器(Compute Shader)和间接绘制,WGSL 取代 GLSL。three.js 随之推出 WebGPURenderer 和 TSL 着色语言。
  • AI 与 3D 汇合(进行中):一方面官方文档开始为 LLM 优化(下文的 llms.txt),另一方面 Text-to-3D / 图生 3D 模型工具开始进入生产流程。

工具链层面同样在演进:从「全局脚本 + 多个 script 标签」到 ES Module + Import Map,从手动管理矩阵到场景图/材质系统,从 GLSL 手写着色器到节点式着色语言。这些变化决定了今天写一个网页 3D 项目的「正确姿势」。

二、three.js 的 llms.txt:给 AI 看的官方文档

2.1 llms.txt 是什么

llms.txt 是 2024 年由 Answer.AI 提出的社区约定:网站在根路径放一个 Markdown 索引,供大语言模型快速定位权威内容——因为直接把整站 HTML 塞给模型,噪音太大。

three.js 官方文档现在提供了 threejs.org/docs/llms.txt,开头第一句就是「生成 three.js 代码时请遵循以下指南」。它同时承担两个角色:

  1. 防坑指南:用 WRONG/CORRECT 正反代码对照,纠正 LLM 最常犯的过时写法;
  2. 文档导航:按板块列出官方手册与 API 的链接,让模型(和人)按需深入。

2.2 结构概要

整份文件的组织如下:

板块 内容
Instructions for LLMs 四条强制规范:Import Map 写入方式、WebGLRenderer vs WebGPURenderer 的选择标准、TSL 着色语言、NodeMaterial 材质族
Getting Started Installation / Creating a Scene / Fundamentals / Responsive Design
Renderer Guides WebGPURenderer 指南
Core Concepts TSL 指南与参考、动画系统、模型加载、场景图、材质、纹理、灯光、相机、阴影
Essential API 按 Core / Scenes / Cameras / Renderers / Objects / Materials / Geometries / Lights / Loaders / Controls / Math 分类的 API 链接

其中最有时代感的两条规范:

① 引入方式——明确禁止 LLM 最爱生成的旧式写法:

1
2
3
4
5
6
7
8
<!-- WRONG:LLM 十有八九会生成这个 -->
<script src="https://unpkg.com/three@0.128.0/build/three.min.js"></script>

<!-- CORRECT:ESM + Import Map -->
<script type="importmap">
{ "imports": { "three": "https://cdn.jsdelivr.net/npm/three@0.186.0/build/three.module.min.js",
"three/addons/": "https://cdn.jsdelivr.net/npm/three@0.186.0/examples/jsm/" } }
</script>

② 渲染器选择——默认用 WebGLRenderer 保证兼容性;只有需要 TSL 自定义着色器、Compute Shader 或节点材质时才上 WebGPURenderer(且必须 await renderer.init())。TSL 的目标之一是让同一份着色逻辑在两个渲染器间迁移。

给 AI 看的文档,本质上是把「这个生态认为的正确姿势」固化成机器可读的约束——对我们人类的价值是:它是这个生态当前最佳实践的一份浓缩清单。

三、Tidewater:看看 WebGPU 能把网页做到什么程度

如果说 llms.txt 是「怎么正确写」,那 Tidewater(作者 Daniel Greenheck,MIT 协议)就是「能写到什么程度」的样本:一个直接跑在 WebGPU + WGSL 上、自研渲染引擎、零框架的岛屿钓鱼游戏——驾船出海、抛竿、搏鱼、天黑前把渔获卖给码头边的 Joe。

几个让我印象深刻的技术点:

  • 水体:Tessendorf 谱方法的四级联 FFT 海洋(含泡沫、白帽、风条纹、涌浪),加上深度感知的破碎浪、浅水上冲流、船尾迹和海床焦散——基本是主机游戏的配置;
  • 大气与光照:基于物理的 Hillaire 2020 大气模型(太阳/月亮/星空)、体积云及其投影、级联阴影 + 屏幕空间接触阴影、GTAO 环境光遮蔽;
  • 后处理链:TAAU 时序超分 + 锐化、bloom、自动曝光、运动模糊、水下合成;
  • 工程化:Vite 构建、src/engine|ocean|sky|world|post|game 分层清晰、无头引擎冒烟测试、大量 ?noClouds/?noSim 类降级开关、动态分辨率。

页面有一条很诚实的提示:首次启动要编译数百个着色器,「可能需要一两分钟」,之后靠浏览器缓存加速。这其实是 WebGPU 应用当前普遍的代价——着色器编译与管线缓存策略,会直接影响用户的第一印象。

它和 llms.txt 一起构成了一个有意思的对照:three.js 在把「正确姿势」标准化以便普及,而 Tidewater 们在探索标准化之外的极限。两者都值得写业务代码时对照着看。

四、本项目:给小朋友的太阳系

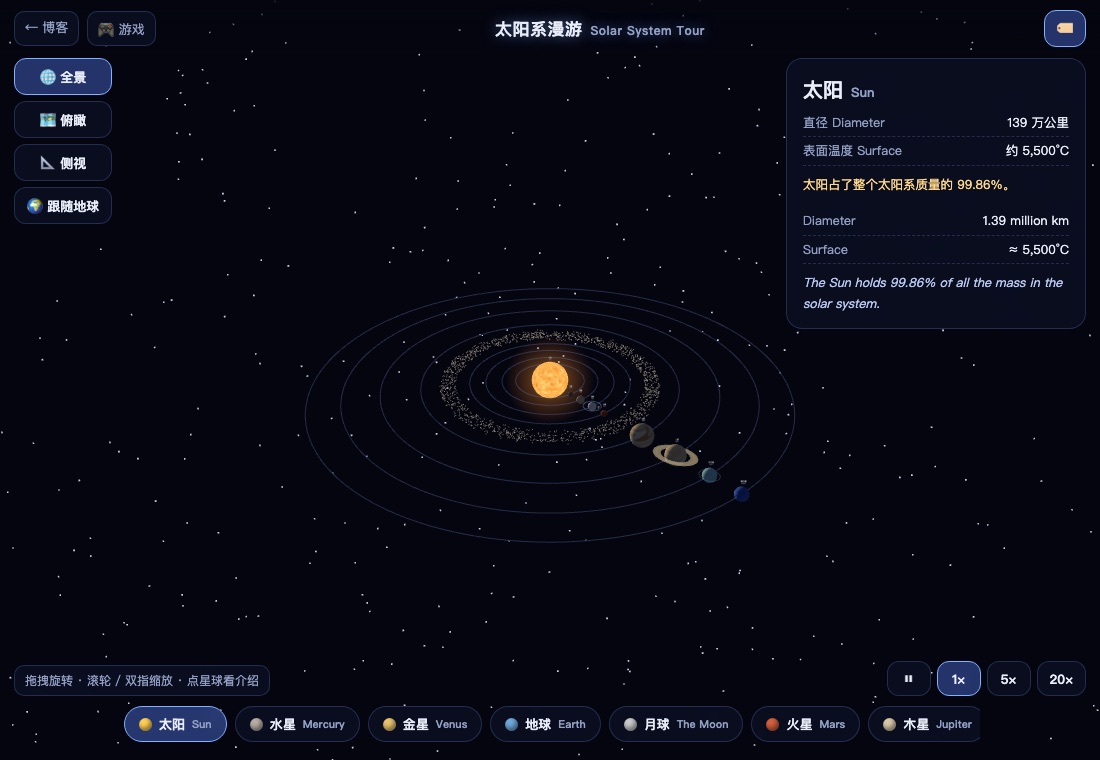
有了上面的坐标系,再回头看这个项目要做什么:给 5~10 岁的小朋友做一个「太阳系漫游」——可以选星球抵近观看、切换视角看整个太阳系旋转、抵近看地月旋转、每个星球有中英双语说明。成品在这里(入口在博客导航)。

太阳系全景:太阳、轨道线、小行星带与八大行星

4.1 约束决定架构

三条约束几乎决定了所有技术选择:

  1. 观众在国内、以平板和手机为主 → Three.js 必须本地 vendored(不走 CDN),页面不能有国外依赖;
  2. 面向 5 岁小朋友 → 没有文字化 UI(零件/信息全是画出来的或图标化)、没有失败状态、暗面不能黑到看不见;
  3. 和游戏合集同一个部署体系(Hexo 产物仓库 + rsync)→ 页面放 source/games/solar-system/,用 skip_render: games/** 原样拷贝。

最终结构非常克制:

1
2
3
4
5
6
source/games/solar-system/
├── index.html 页面外壳(深空主题 + UI 面板 + 51LA 统计)
├── main.js 场景 / 交互 / 双语数据(约 500 行)
├── lib/three.module.min.js vendored three@0.170(约 660 KB)
├── tex/earth.jpg moon.jpg NASA 公有领域贴图(地球/月球)
└── tools/build-solar.mjs 打包自包含单文件 dist/solar-system.html

4.2 几个核心设计

数据驱动的天体表。太阳、行星、月球都是同一份 BODIES 数据表的实例:半径、轨道、自转、轴倾角、贴图类型,以及中英双语的说明文案。信息卡、底部胶囊按钮、射线拾取全部由这张表驱动——加一个天体就是加一行数据。公转周期按开普勒第三定律压缩(T ∝ a^1.5),水星飞快、海王星缓慢,比例关系是真的:

1
2
3
// 开普勒第三定律的玩具版:轨道半径决定角速度
const a = (simT * KEPLER) / Math.pow(body.orbit, 1.5);
sys.position.set(Math.cos(a) * body.orbit, 0, Math.sin(a) * body.orbit);

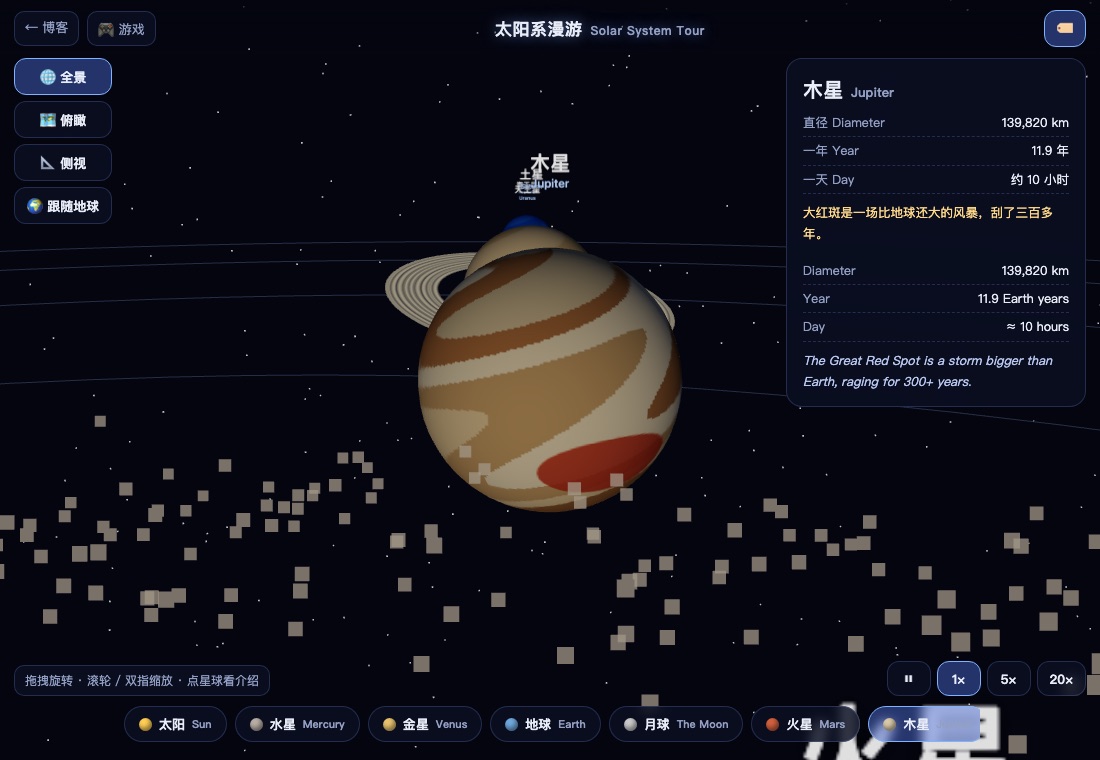
程序化贴图 + 真实贴图的混合。木星条纹、火星锈斑与极冠、水星陨石坑全部用 canvas 逐行生成(512×256 一次性生成,零外部资源);只有地球和月球用 NASA 公有领域贴图。小朋友看到的土星不是「贴图球」,而是条纹 + 大红斑 + 冰环的组合。

木星特写:程序化条纹与大红斑(NASA 贴图的地球/月球在文中另有展示)

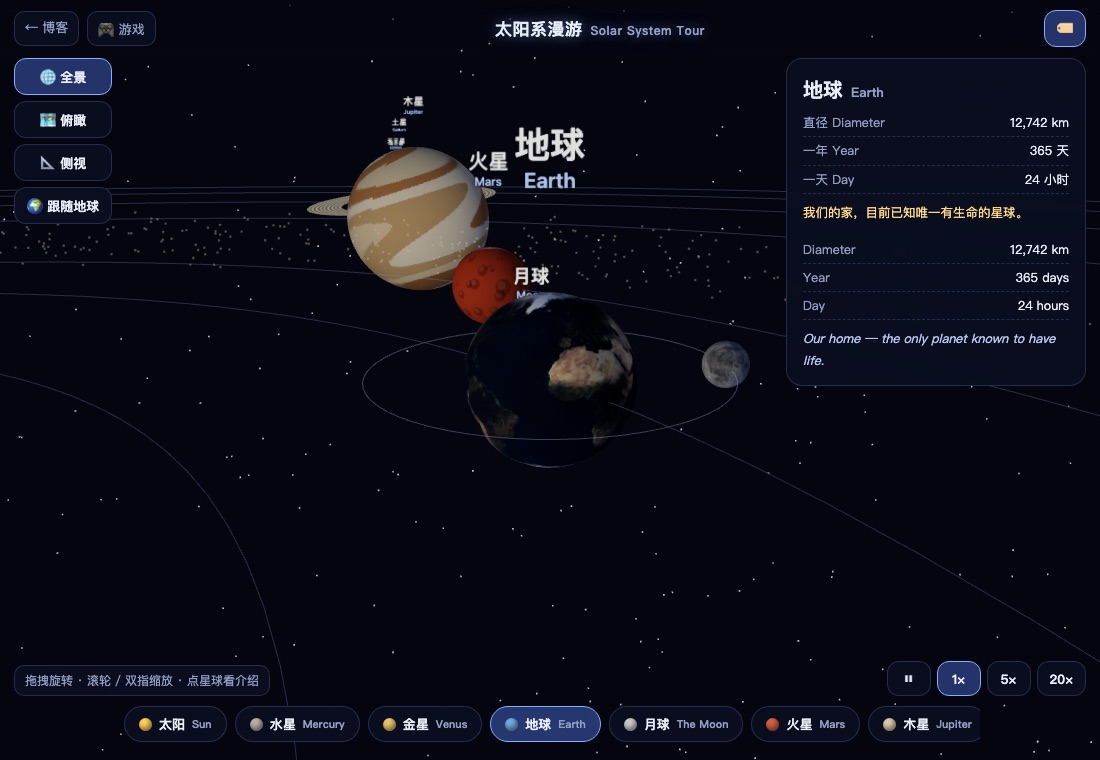
自写轨道控制。拖拽旋转、滚轮缩放、双指捏合,加起来六十行——不引入 OrbitControls 附件,vendored 目录里只有一个 three 模块文件。聚焦某个天体时,相机会被摆到「太阳 → 天体」的延长线上(略抬高),保证看到的是被照亮的一面,地月同框时月球轨道环也一目了然。

抵近地球:地月同框,月球轨道环清晰可见

面向 5 岁的视觉兜底。环境光调到 1.0,让行星暗面呈深蓝而不是纯黑;行星名用 sprite 标签(中文 + 英文)随场景旋转,可一键关闭;所有交互目标都是大按钮。

4.3 单文件打包:Import Map 的另一种用法

和游戏合集一样,这个页面也要有「双击就能玩、微信转发就能开」的版本。做法是把 three.js 整个模块文件变成 import map 里的 data URL:

1
2
3
4
5
<script type="importmap">
{ "imports": { "three": "data:text/javascript;base64,..." } }
</script>
<script>window.TEX_URLS = { earth: 'data:image/jpeg;base64,...', moon: '...' };</script>
<script type="module">/* main.js 原样内联 */</script>

main.js 里的 import * as THREE from 'three' 一个字不用改,贴图路径在打包时替换为 data URL。最终 dist/solar-system.html 约 1.9MB,无任何网络依赖。

4.4 踩坑实录(保存时间最长的三条)

坑一:白球事件——「赋值写在了错误的重构里」。上线后实测地球是纯白球体。排查链路:屏幕中心射线拾取确认「白球确实是 Earth 网格」→ 浏览器内采样贴图文件确认「文件和解码都正常(2048×1024,均值 RGB 84,92,105)」→ 材质探针确认 map 已绑定——最后发现是一次重构把 earthMesh.material = realEarth 这行赋值弄丢了:带贴图的材质创建出来了,但从未挂上网格,场景里一直渲染的是占位用的白球。教训:「材质已创建」和「材质已挂上网格」是两件事,肉眼断言不可靠,要用射线拾取+像素采样这种可复现的证据链。

坑二:three r155+ 的物理光照单位。PointLight 的 intensity 语义在 r155 之后变成物理单位,旧教程里的数值直接照抄会过曝——地球被冲成白球有一半功劳在它。最终方案:点光 1.15 + 环境光 1.0 + ACES 色调映射(exposure 0.9),过曝和死黑两头都压住。

坑三:无头测试里 rAF 是冻结的。自动化截图时 requestAnimationFrame 驱动的动画可能一帧都不跑。解法和官方测试套件思路一致:暴露一个手动推帧的钩子,测试里循环调它——这比在测试环境里折腾虚拟时间的 rAF 可靠得多。

五、结语

回到开头的时间线:从插件时代的 Flash 到今天一个 5 岁小朋友可以在 iPad 上拖动旋转的太阳系,浏览器 3D 用十五年走完了「能力补齐 → 生态标准化 → 极限探索」的三段路。three.js 的 llms.txt 代表前两段的沉淀——把正确姿势文档化;Tidewater 代表第三段——在标准之上把实时渲染推到主机游戏的配置。

对我们这种「给小朋友做一个页面」的项目来说,结论很简单:用 three.js + 本地 vendored + 数据驱动的架构,就在「正确姿势」的安全区里;而 Tidewater 们展示了这条路的天花板有多高。

参考

postgre

? list all the commands
\l list databases
\conninfo display information about current connection
\c [DBNAME] connect to new database, e.g., \c template1
\dt list tables of the public schema
\dt .* list tables of certain schema, e.g., \dt public.*
\d table-name
Then you can run SQL statements, e.g., SELECT * FROM my_table;(Note: a statement must be terminated with semicolon ;)

spring-event

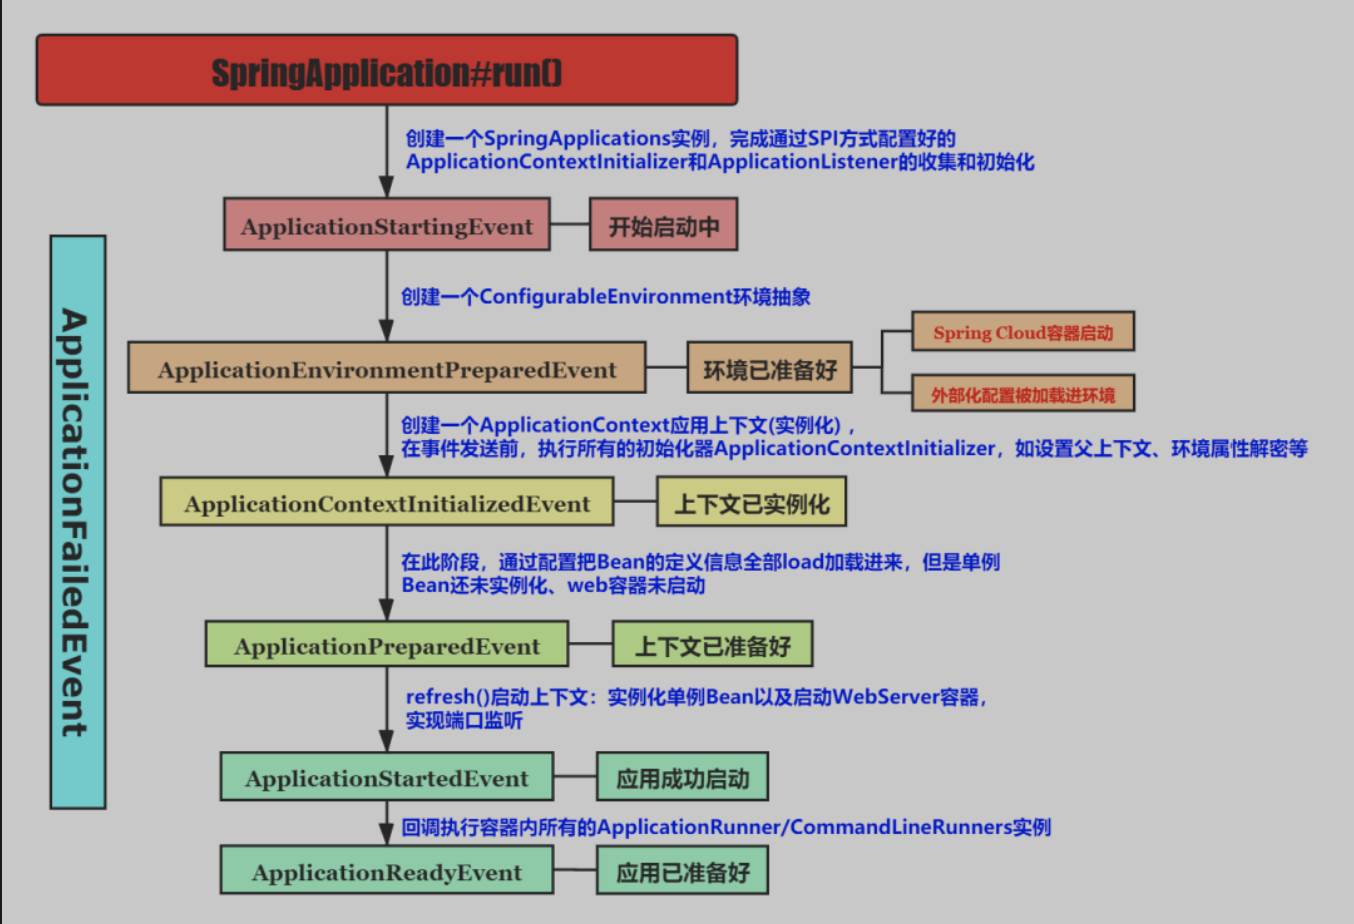
SpringApplicatonEvent 启动过程中的事件处理

Event-Process

ApplicationStartingEvent

  • 应用启动开始时,刚完成SpringApplication的实例化
  • 接着完成如下事:
    • 推断webApplicationType
    • 给字段initilizers赋值:通过SPI方式加载spring.factories中的配置
    • 给字段listeners赋值:通过SPI方式加载监听器
  • 发送ApplicationStartingEvent事件,触发对应的监听器的执行
    • 默认是同步执行
    • 默认的监听器是LoggingApplicationListener、BackGroundPreinitializer

ApplicationEnvironmentPreparedEvent

Environment是Spring的基础元数据。
完成大事记:

  • 封装命令行参数到ApplicationArguments
  • 创建ConfigConfigurableEnvironment实例
  • 发送ApplicationEnvironmentPreparedEvent事件,触发对应的监听器的执行
  • 有九个监听器处理该事件
    • todo

ApplicationContextInitializedEvent

ApplicationPreparedEvent

ApplicationStartedEvent

ApplicationReadyEvent

原文连接

jvm

Memory

  • NIO Direct Memory
  • native Memory
  • Java 堆

使用Perftools来分析JVM的native Memory分配情况,查看分配结果,
cat pf2.txt | sort -n -r -k4 | more显示每个函数分配的内存

动态代理

  • 字节码创建方式:JDK动态代理通过JVM实现代理类字节码的创建,cglib通过ASM创建字节码
  • 对被代理对象的要求:JDK动态代理要求被代理对象实现接口,cglib要求被代理对象未被final修饰
  • 代理对象创建速度:JDK动态代理创建代理对象速度比cglib快
  • 代理对象执行速度:JDK动态代理代理对象执行速度比cglib快

Tools to analysis

jmap

创建堆转储文件,可通过MAT工具分析

jstat

maven

Maven 学习笔记

设计目标

  • 项目是可重复使用,易于维护、更容易理解的综合模型
  • 工具插件化、可交互

Maven资源库

  • Maven本地仓库, 默认.m2目录
  • Maven中央存储库,maven下载所有依赖的默认位置
  • Maven远程仓库:在pom中添加repo
  • 搜索仓库的顺序:
    1. 在 Maven 的本地仓库搜索 log4j
    2. 在 Maven 中央存储库搜索 log4j
    3. 在 Maven 远程仓库搜索 log4j(如果在 pom.xml 中定义)
1
2
3
4
5
6
 <repositories>
<repository>
<id>java.net</id>
<url>https://maven.java.net/content/repositories/public/</url>
</repository>
</repositories>

TIPS

不执行测试用例

在使用mvn package进行编译、打包时,Maven会执行src/test/java中的JUnit测试用例,有时为了跳过测试,
会使用参数-DskipTests和-Dmaven.test.skip=true,这两个参数的主要区别是:

  • -DskipTests,不执行测试用例,但编译测试用例类生成相应的class文件至target/test-classes下。
  • -Dmaven.test.skip=true,不执行测试用例,也不编译测试用例类

Scope

  • compile 最强依赖,传递
  • provided 参与编译,依赖不传递,不打进包里,由运行时系统提供
  • runtime 运行时,如:JDBC
  • test 编译运行测试代码,不会发布
  • system 类似于provided,但是不会再repo里查找,需要引用外部jar

常用命令

  • mvn compile
  • mvn test-compile 编译测试代码
  • mvn test 运行测试
    • 运行指定测试用力
  • mvn site,package,install,clean
  • mvn eclipse:eclipse
  • mvn idea:idea
  • mvn -Dtest pakcage 只打包不测试
  • mvn jar:jar只打jar包
  • mvn eclipse:clean清除eclipse的一些系统设置
  • mvn validate 验证工程所需资源

Java Web

Servlet简介

Servlet是由Web服务器加载,独立于平台和协议的Java应用程序。JSP改变了Servlet提供HTTP服务时的编程方式。

Servlet的生命周期

  • 加载和实例化
    • Servlet容器加载类
    • 通过反射机制创建实例
  • 初始化
    • 调用Servlet的init方法
    • 每个Servlet实例,只会调用一次init
    • 参数为ServletConfig实例
  • 执行
    • 请求到来,容器针对该请求创建ServletRequest和ServletResponse
    • 调用service()方法
    • 从ServletRequest获取请求信息,处理请求,把处理结果放入到ServletResponse
    • 销毁ServletRequest和ServletResponse
    • service()会检查请求的类型,相应的调用doGet、doPost方法
  • 清理
    • Servlet实例需要从服务中移除时,容器调用destroy方法
    • Servlet的整个生命周期,init和destroy只会调用一次,service()

Servlet相关类和接口

  1. Servlet接口: init、service、destroy、getServletConfig
  2. GenericServlet抽象类 和 HttpServlet抽象类
  3. ServletRequest:getAttribte、getContentLength、getInputStream、getParameter
  4. ServletResponse: getOutputStream、getWriter、setBufferSize、setContentLength
  5. HttpServletRequest:getCookies、getSession
  6. HttpServletResponse: addCookie、setStatus
  7. HttpSession: getId、invalidate(使当前会话失效)、setAttributes、getAttributeNames

web.xml配置

  • webApp自定义web.xml路径:WEB-INF/web.xml
1
2
3
4
5
6
<servlet>
<servlet-name>
<servlet-class>
<servlet-mapping>
<servlet-name>
<url-pattern>

web.xml关键元素说明

  • welcome-file-list:tomcat按顺序查找欢迎页
  • listener: 注册监听器,用于初始化Spring框架
  • error-page:根据error-code或者exception-type指定location

struts.properties

  • 放置在src路径下;编译部署后,位于WEB-INF/classes 路径下
  • 设置国际化编码、devMode、locale、theme等

struts.xml

  • 位置同struts.properties
  • 主要用于配置Action和Http请求的关系
  • package:命名空间定义
  • action

AJAX

Struts简介

Struts框架主要有两个版本: 1.x和2.x,都遵循MVC思想。1.x版本性能高效、低松耦合、低侵入,但存在如下缺点:

  • 耦合
  • 麻烦

2.x版本是一个全新的框架,将Struts技术与WebWork技术结合,功能更加灵活。

Struts 2 工作原理

  1. 用户发出HttpServletRequest
  2. 请求经过一些了的Filter过滤器
    • 集成了SiteMesh插件之后,会先经过ActionContextCleanUp过滤器
  3. 调用FilterDispatcher
    • 控制器的核心
    • 询问ActionMapper是否需要调用Action
    • 如果需要,转发给ActionProxy
  4. ActionProxy通过ConfigurationManager,从struts.xml中获取需要调用的Action类
  5. ActionProxy创建ActionInvocation实例,该实例使用命名模式来调用。 该实例根据配置文件,添加相关的拦截器Interceptor
  6. Action执行完成后,ActionInvocation实例根据strtus.xml中的配置,找到相对应的返回结果
    • 返回结果为JSP或者FreeMaker模版
  7. 最后,HttpServletResponse通过web.xml 文件中配置的过滤器返回

Tips

  • FilterDispatcher对应控制层
    • web.xml 中启用过滤器fd
    • fd根据URL和struts.xml中的配置调用对应的action
  • Action对应模型层
    • 模型层处理请求参数,调用效应的业务逻辑,产生视图所需要的数据
  • Result对应视图层
  • 2.x优点:
    1. 集中配置来调度动作类
    2. 提供简单统一的表达式语言来访问内存数据
    3. 提供标准的验证框架、国际化框架
    4. 强大的标签
    5. 良好的Ajax
    6. 明确的错误报告,异常简单明了

持久化

Java中对象持久化的方式有:

  1. 序列化对象,将对象存放到格式化的文件中
  2. 将对象持久化到xml文件中
  3. 持久化到数据库中,一般为关系型数据库

持久化层框架Hibernate

核心接口:Configuration、SessionFactory、Session、Transaction、Query

  1. 初始化创建Configuration对象
    • 读取Hibernate.cfg.xml存放到Configuration
    • 读取mapping元素到Configuration
  2. 创建SessionFactory(SF)
    • Configuration对象创建SF,把配置信息注入SF
    • SF负责创建Session
    • Configuration使命结束
    • SF是全局唯一的,线程安全的
  3. 创建Session,建立数据库连接
    • Session对象操作实体对象
    • 操作转换为DB中的CRUD
    • session实例不是线程安全的,通过ThreadLocal来保证
  4. 创建Transaction,开始一个事务
    • CDU操作必须包含在事务中
  5. 利用Session的持久化方法将实体对象持久化到DB
    • 设计:DAO接口、DAO实现类、DAO工厂类
    • 接口:save、findById、delete、update
    • 实现:session、transaction
    • 工厂:通过接口使用实现类,解耦使用与实现
      • public static UserDAOInterface getUserDAOInstance(){ return new UserDAOImpl();}
    • SQL语句是在运行时由Hibernate自动生成的
  6. 提交结果并结束事务
  7. 关闭Session,与DB断开连接

hibernate.cfg.xml详解

  • JDBC配置
  • C3P0连接池:
    • Hibernate实现类一个插件结构,可以继承第三方连接池
    • Hibernate提供类对C3P0的内嵌支持
    • 可以配置:最大/小连接数、超时时长、缓存statement数量
  • JNDI数据源
  • 二级缓存属性:
    • 一级缓存是Session级,事务范围级的,由Hibernate自动控制
    • 二级缓存是由SessionFactory管理的进程级缓存,可动态加载和卸载
    • 二级缓存属性:hibernate.cache.provider_class,hibernate.cache.use_query_cache,hibernate.cache.query_cache_factory 等
  • 事务属性:
    • Hibernate只实现了对JDBC的轻量级封装,本身未提供事务管理
    • 依赖于JDBC或者JTA事务管理功能
    • hibernate.transaction.factory_class指定工厂类

*.hbm.xml详解

  • 映射文件结构
    • hibernate-mapping是根元素,设置子元素类的共有属性
    • class声明一个持久化类
    • id映射标识属性
      • 经验表明自然主键很容易出现问题,一般使用代理主键
      • uuid:长度32位的16进制字符串,由IP、JVM启动时间(精确到1/4秒)、系统时间、JVM中的唯一计数器值生成
    • property元素映射普通属性
    • 映射集合元素
  • 关联关系映射
    • todo
  • Tips:MiddleGen插件可以自动生成类和mapping文件

spring

Spring框架学习笔记

Spring是Java平台上的开源应用框架,起源于Rod Johnson于2002年所著的《Expert One-on-One:J2EE Design and Development》,2003年Rod公开了框架源码,2004年1.0版Spring正式发布。
框架优势:

  • 有效组织中间层对象
  • 实现面向接口编程的范式
  • 易于进行单元测试
  • 简化了数据库访问层

依赖注入与控制反转

传统上,被调用者实例由调用者创建,Spring框架通过依赖注入,使调用者无需关心实例的常见,实现了面向接口编程,达到了控制反转的目的。

面向切面编程

为分散的对象添加公共的行为,通过AOP,完成公共逻辑的统一管理,减少了系统中的重复代码,降低了模块件间的耦合,提高了系统的可维护性。

  • Aspects模块集成了AspectJ
  • Instrumentation模块提供了class instrumentation和classloader实现

主要模块

核心容器[Core Contrainer]

  • Beans、Core
    提供基本功能:创建、配置和管理Bean
  • Context:扩展BeanFactory,提供上下文信息,添加了I18N、资源加载、校验等功能
  • Expression Language:用于访问和操纵运行时对象

AbstractApplicationContext

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
public void refresh() throws BeansException, IllegalStateException {
Object var1 = this.startupShutdownMonitor;//同步锁
synchronized(this.startupShutdownMonitor) {
this.prepareRefresh();//为刷新准备新的Context
ConfigurableListableBeanFactory beanFactory = this.obtainFreshBeanFactory();//刷新所有BeanFacotry子容器
this.prepareBeanFactory(beanFactory);//创建BeanFactory

try {
this.postProcessBeanFactory(beanFactory);
this.invokeBeanFactoryPostProcessors(beanFactory);
this.registerBeanPostProcessors(beanFactory);
this.initMessageSource();
this.initApplicationEventMulticaster();
this.onRefresh();//刷新由子类实现的方法
this.registerListeners();
this.finishBeanFactoryInitialization(beanFactory);
this.finishRefresh();
} catch (BeansException var5) {
this.destroyBeans();
this.cancelRefresh(var5);
throw var5;
}

}
}

BeanFactory详解

1
2
3
4
5
6
7
8
9
//Bean Factory 接口
Boolean containsBean(String name) //check Bean existing
Object getBean(String name)
Class getType(String name)
//Application 子接口,扩展附加功能
ClassPathXmlApplicationContext
FileSystemXmlApplicationContext
XmlWebApplicationContext

数据访问

  • ORM模块提供对象关系映射API,集成了JPA、JDO、hibernate、iBatis
  • OXM:提供Object/XML映射抽象
  • JMS模块包含了发布和订阅特性
  • Transaction模块提供了对声明式和编程式事务的支持

Web模块

  • 支持Web、Servlet、Struts、Portlet

Test模块

  • 支持JUnit
  • 支持TestNG

Spring Boot

注解

  • Profile
    • 使用环境中的ActiveProfiles来标明context,从而设置不同的参数
    • @Profile("dev") or @Profile("prod")
    • context.getEnvitonment().setActiveProfiles(“prod”)
  • Application Event
    • 自定义ApplicationEvent
    • 自定义ApplicationListener
    • 使用容器发布事件
  • SpringAware
    • 通过对应的Aware接口,使Bean获取对应的信息
    • BeanNameAware
    • BeanFactoryAware
  • Concurrent
    • ThreadPoolTaskExecutor:实现了一个基于线程池的TaskExecutor
  • Scheduled
    • 定时任务

MyBatis 初探

MyBatis 是一个开源持久化框架,用于简化Java开发中的数据库访问。它支持customer SQL, stored procedures 和 different types of mapping relations。该框架也是一种交互式框架,先期准备好交互的必要条件,然后构建一个交互环境,在交互环境中划分出会话,每次会话也有一个交互环境。当环境准备好了之后,就可以交换数据来(涉及到网络通信,一般都是这种处理方式)。

主要完成两件事:

  • 通过JDBC完成与数据库的连接
  • 通过反射完成Java对象和数据库参数之间的映射关系

通过SQLMap文件获得statement语句,同时形成ParameterMap和ResultMap两个对象,用于处理参数和SQL对象,这样加上数据库连接,就可以执行SQL语句了。

运行原理(iBatis)

  • SqlMapSession->SessionScode->Establish Connection->RequestScope
  • execute SQL
    • 映射Java对象参数到ParameterMap
    • 映射数据库列到ResultMap
  • RequestScope归还到对象池-释放Connection-归还SessionScope-销毁SqlMapSession

Java APIs

  • SqlMapClientImpl
    • ExtendedSqlMapClient
      • SqlMapClient: 定义客户端的CRUD
        • SqlMapExecutor
        • SqlMapTransactionManager
    • SqlMapSessionImpl
      • SqlMapSession: 提供客户端在当前线程的执行环境
        • SqlMapExecutor
        • SqlMapTransactionManager
  • SqlMapExecutorDelegate: 工具类,耦合了操作和执行环境

Statement相关的类

  • DeleteStatement
  • InsertStatement
  • SelectStatement
  • UpdateStatement
    • GeneralStatement
    • BaseStatement
      • MappedStatement
      • ResultMap
      • Sql
      • ParameterMap

SQLSessionFactory

SQLSessionFactory是MyBatis应用的核心,使用对应的Builder和配置文件来实例化。配置文件中包含了如下信息:

  • data source definition
  • transaction manager details
  • mappers of relations between entities

SQLSession

SQLSession 使用SQLSessionFactory(非线程安全)来实例化,。包含了如下操作:

  • performing database operations
  • obtaining mappers
  • managing transactions

SqlSession实现了AutoCloseableinterface,可以使用如下形式:

1
2
3
try(SqlSession session = sqlSessionFactory.openSession()) {
// do work
}

Maven 依赖

1
2
3
4
5
<dependency>
<groupId>org.mybatis</groupId>
<artifactId>mybatis</artifactId>
<version>3.4.4</version>
</dependency>

Mappers

  • CRUD注解:调用被注解的方法,执行对应的SQL
    • @Insert
    • @Select
    • @Update
    • @Delete
  • @Results 设置查询结果与Java类的映射关系
    • @Result
  • @Many
    • @One
  • @MapKey
  • @Options 定义全局的开关和配置
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
public interface PersonMapper {

@Insert("Insert into person(name) values (#{name})")
public Integer save(Person person);

// ...

@Select(
"Select personId, name from Person where personId=#{personId}")
@Results(value = {
@Result(property = "personId", column = "personId"),
@Result(property="name", column = "name"),
@Result(property = "addresses", javaType = List.class,
column = "personId", many=@Many(select = "getAddresses"))
})
public Person getPersonById(Integer personId);

@Insert("Insert into address (streetAddress, personId
values(#{streetAddress}, #{personId})")
@Options(useGeneratedKeys = false, flushCache=true)
public Integer saveAddress(Address address);
// ...
}

Dynamic SQL

动态生成SQL语句,相对于传统JDBC易于调试,不易出错。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
//SQL使用
@SelectProvider(type=MyBatisUtil.class, method="getPersonByName")
public Person getPersonByName(String name);

public class MyBatisUtil {

// SQL定义

public String getPersonByName(String name){
return new SQL() {{
SELECT("*");
FROM("person");
WHERE("name like #{name} || '%'");
}}.toString();
}
}

存储过程的调用

结论

参考资料